Publications

(* equal contribution)

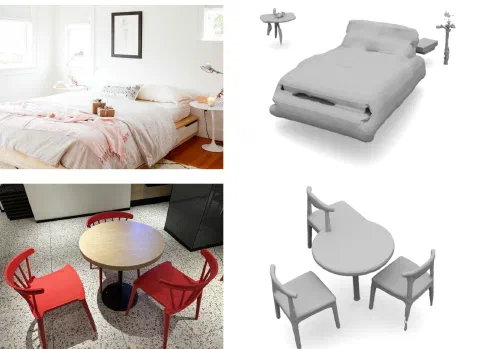
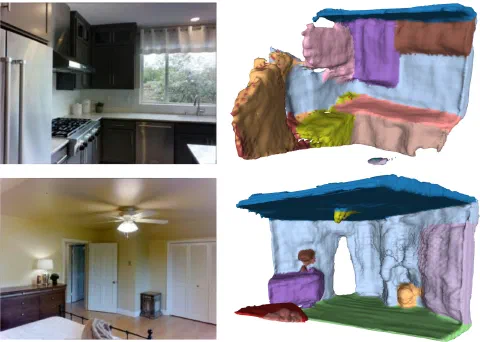
[1] PixARMesh: Autoregressive Mesh-Native Single-View Scene Reconstruction
Xiang Zhang*, Sohyun Yoo*, Hongrui Wu*, Chuan Li, Jianwen Xie, Zhuowen Tu
CVPR 2026
[2] CVP: Central-Peripheral Vision-Inspired Multimodal Model for Spatial Reasoning
Zeyuan Chen, Xiang Zhang, Haiyang Xu, Jianwen Xie, Zhuowen Tu
WACV 2026
[3] Gaussian Swaying: Surface-Based Framework for Aerodynamic Simulation with 3D Gaussians
Hongru Yan, Xiang Zhang, Zeyuan Chen, Fangyin Wei, Zhuowen Tu
WACV 2026
[4] OverLayBench: A Benchmark for Layout-to-Image Generation with Dense Overlaps
Bingnan Li*, Chen-Yu Wang*, Haiyang Xu*, Xiang Zhang, Ethan J. Armand, Divyansh Srivastava, Xiaojun Shan, Zeyuan Chen, Jianwen Xie, Zhuowen Tu
NeurIPS 2025
[5] VertexRegen: Mesh Generation with Continuous Level of Detail
Xiang Zhang, Yawar Siddiqui, Armen Avetisyan, Chris Xie, Jakob Engel, Henry Howard-Jenkins
ICCV 2025
[6] DepR: Depth Guided Single-view Scene Reconstruction with Instance-level Diffusion
Qingcheng Zhao*, Xiang Zhang*, Haiyang Xu, Zeyuan Chen, Jianwen Xie, Yuan Gao, Zhuowen Tu
ICCV 2025
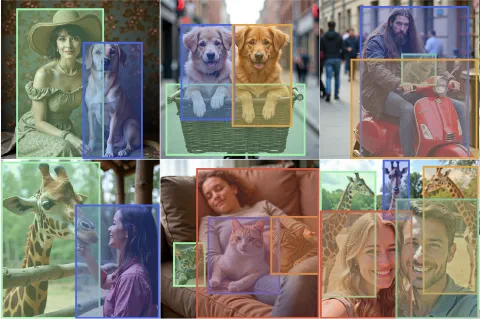
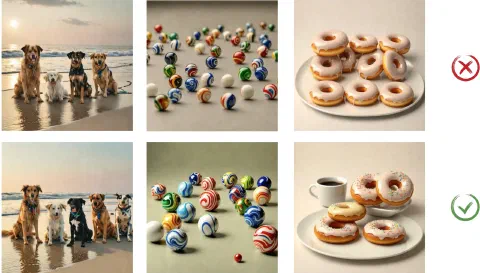
[7] YOLO-Count: Differentiable Object Counting for Text-to-Image Generation
Guanning Zeng, Xiang Zhang, Zirui Wang, Haiyang Xu, Zeyuan Chen, Bingnan Li, Zhuowen Tu
ICCV 2025
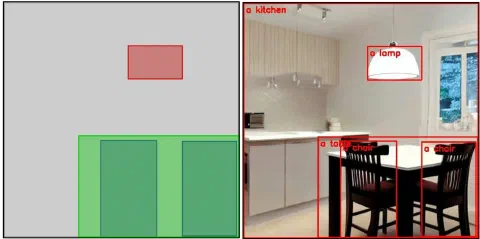
[8] Lay-Your-Scene: Natural Scene Layout Generation with Diffusion Transformers
Divyansh Srivastava, Xiang Zhang, He Wen, Chenru Wen, Zhuowen Tu
ICCV 2025
[9] C3Editor: Achieving Controllable Consistency in 2D Model for 3D Editing
Zeng Tao, Zheng Ding, Zeyuan Chen, Xiang Zhang, Leizhi Li, Zhuowen Tu
ICCVW 2025 (Wild3D)
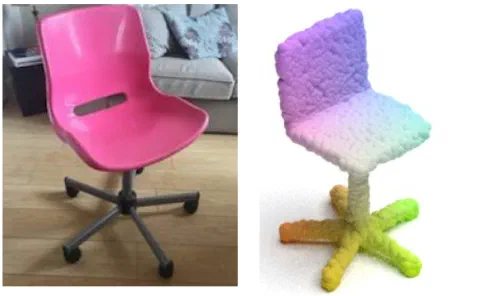
[10] Bayesian Diffusion Models for 3D Shape Reconstruction
Haiyang Xu*, Yu Lei*, Zeyuan Chen, Xiang Zhang, Yue Zhao, Yilin Wang, Zhuowen Tu
CVPR 2024
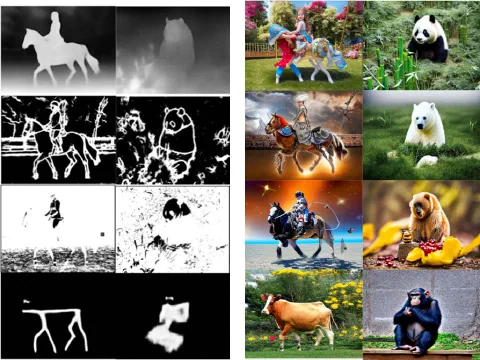
[11] OmniControlNet: Dual-stage Integration for Conditional Image Generation
Yilin Wang*, Haiyang Xu*, Xiang Zhang, Zeyuan Chen, Zhizhou Sha, Zirui Wang, Zhuowen Tu
CVPRW 2024 (GCV)
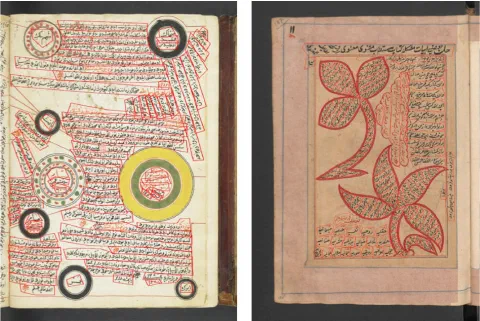
[12] MONSTERMASH: Multidirectional, Overlapping, Nested, Spiral Text Extraction for Recognition Models of Arabic-Script Handwriting
Danlu Chen, Jacob Murel, Taimoor Shahid, Xiang Zhang, Jonathan Parkes Allen, Taylor Berg-Kirkpatrick, David A Smith
ICDAR 2024 Workshops
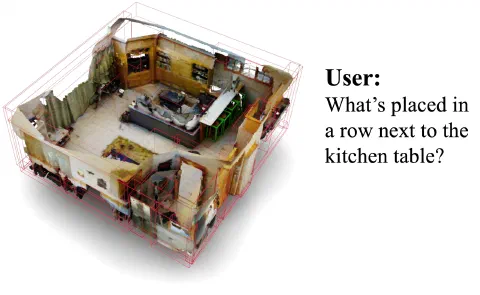
[13] Uni-3D: A Universal Model for Panoptic 3D Scene Reconstruction
Xiang Zhang*, Zeyuan Chen*, Fangyin Wei, Zhuowen Tu
ICCV 2023
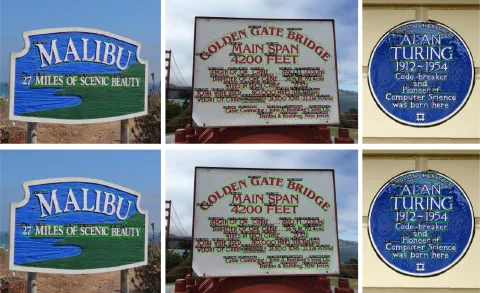
[14] Text Spotting Transformers
Xiang Zhang, Yongwen Su, Subarna Tripathi, Zhuowen Tu
CVPR 2022
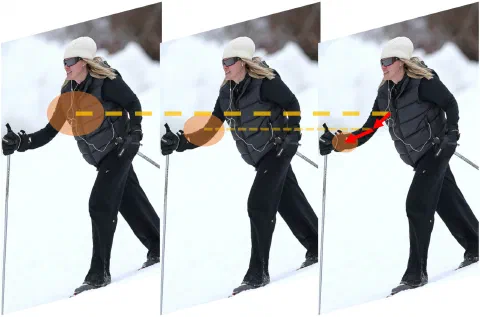
[15] Pose Recognition with Cascade Transformers
Ke Li*, Shijie Wang*, Xiang Zhang*, Yifan Xu, Weijian Xu, and Zhuowen Tu
CVPR 2021